Проверка полноты анализа по идентификаторам, пропускам и дублям. Учебный пример показывает, почему одинаковое число строк ещё не подтверждает результат.
Отчёт по отзывам можно принять только после сверки с исходными записями. Модель способна выдать убедительные темы и проценты, пропустив часть файла. Фраза «проанализированы все отзывы» ничего не доказывает. Для проверки нужны идентификаторы строк, список исключений и понятное правило подсчёта.
Такая проверка особенно полезна, когда отзывы обрабатываются несколькими партиями. В одной партии модель вернула весь результат, в другой пропустила длинное сообщение, в третьей повторила последнюю строку предыдущей. Итоговый текст при этом может выглядеть совершенно нормальным.
Сначала определите, что считается одним отзывом
Возьмём учебную выгрузку из восьми записей. Каждой назначен постоянный идентификатор R01–R08. Один отзыв может содержать несколько предложений и касаться двух проблем. Это всё ещё одна исходная запись. Перенос строки внутри текста не создаёт новый отзыв.
До обработки сохраните исходную таблицу. Отдельно запишите число записей, число уникальных идентификаторов и число пустых текстов. Идентификатор должен относиться к отзыву и сохраняться после сортировки. Обычный номер строки для этого неудобен, если таблицу будут перестраивать.
Два одинаковых текста тоже требуют решения. Покупатель мог отправить сообщение повторно, либо два человека оставили одинаковую короткую оценку. Удалять такие строки только по сходству текста нельзя. Правило удаления дублей зависит от происхождения выгрузки и цели исследования.
Попросите результат для каждой записи
Вместо одного общего пересказа запросите таблицу. Минимальный набор полей — исходный идентификатор, статус обработки, основная тема, дополнительные темы и короткий фрагмент текста, на котором основана классификация. Фрагмент позволяет проверить смысл без поиска по всему файлу.
Обработай учебную таблицу отзывов. Для каждого исходного ID верни ровно одну строку. Сохрани ID без изменений. Укажи статус обработки, основную тему, дополнительные темы и подтверждающий фрагмент. Если текст пустой, повреждён или непонятен, сохрани строку и объясни проблему. Пока не рассчитывай проценты и не делай общий вывод.
Список тем лучше задать заранее на небольшой пробной выборке. Например, доставка, упаковка, качество товара и другое. Если категории уточняются в процессе, повторно проверьте ранние партии по той же версии правил. Иначе одинаковые жалобы попадут в разные группы.
Проверьте состав идентификаторов
В нашем примере результат содержит R01, R02, R03, R04, R05, R06, R06 и R08. На входе восемь строк и на выходе восемь. Однако R07 отсутствует, а R06 повторяется. Сверка только количества строк пропустит обе ошибки.
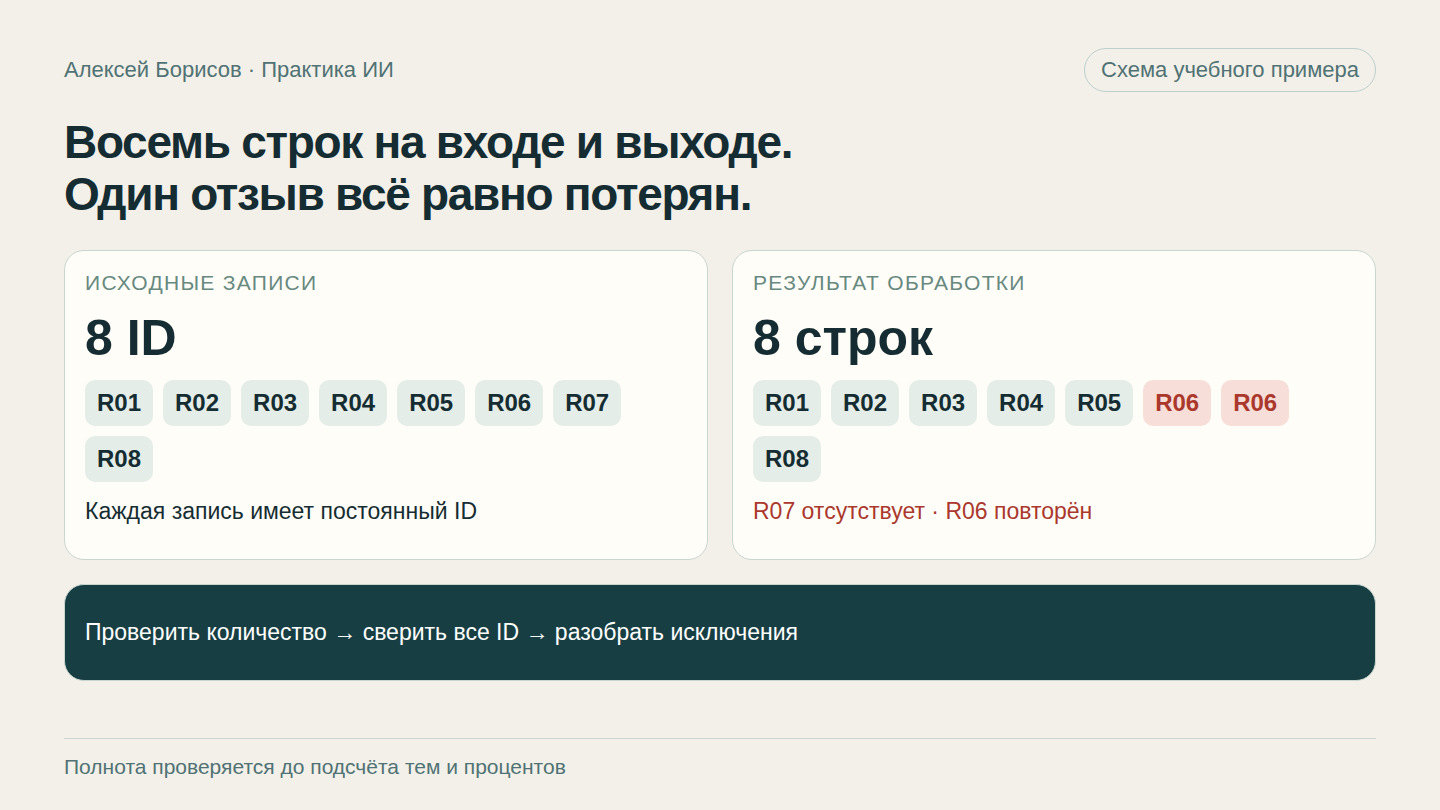
Сопоставьте два списка идентификаторов. В результате не должно появиться неизвестных ID. Каждый исходный ID должен встретиться ровно один раз, включая записи со статусом «не удалось обработать». Для проверки подойдут сравнение списков в таблице, объединение запросов или небольшой скрипт.
В Excel функция СЧЁТЕСЛИ позволяет посчитать, сколько раз исходный идентификатор встретился в столбце результата. Ноль означает пропуск, единица соответствует ожидаемому количеству, больше единицы требует разбора повторов. Принцип функции описан в справке Майкрософт по COUNTIF, проверенной 11 октября 2026 года. Обратная сверка нужна для поиска посторонних идентификаторов.
Считайте доли после проверки полноты
Предположим, исправленная таблица содержит восемь отзывов. В трёх говорится о доставке, в двух об упаковке, в одном одновременно о доставке и упаковке. Этот шестой по описанию случай входит в обе тематические группы. При подсчёте тем получается четыре упоминания доставки и три упоминания упаковки.
Если делить число отзывов с темой на все восемь записей, получаем 50% для доставки и 37,5% для упаковки. Сумма долей по всем темам может превысить 100%, потому что один отзыв относится к нескольким темам. Если нужна разбивка ровно на 100%, заранее назначьте каждому отзыву одну основную категорию и отдельно храните дополнительные.
Пустые и нечитаемые записи не прячьте. Например, при одном пустом тексте можно считать доли от семи содержательных отзывов. В подписи к результату нужно прямо указать такой знаменатель. Делить разные категории на разные основания нельзя.
Отдельно проверьте смысл разметки
Полное совпадение ID подтверждает охват. Дальше нужна содержательная проверка. Прочитайте несколько обычных отзывов, все неоднозначные случаи и записи, где модель указала проблему. Сверьте цитаты с исходником. Фраза «доставили вовремя, коробка помята» относится к упаковке; само слово «доставили» ещё не означает жалобу на доставку.
Для повторяемой работы сохраните небольшой контрольный набор с утверждённой разметкой. После изменения инструкции или модели прогоните его снова. Размер набора выбирается под разнообразие обращений. Несколько удачных строк не доказывают качество на всём потоке.
Готовый результат состоит из проверенной построчной таблицы, перечня исключений и сводки с явным основанием процентов. Именно этот комплект позволяет руководителю понять, насколько выводы соответствуют исходным отзывам. На корпоративном обучении ИИ такой порядок можно отработать на разрешённой выгрузке своего подразделения.